Видеоаналитика на локальном устройстве: исследование EdgeCrafter
У локального вычислителя ограничены память и производительность. EdgeCrafter исследует, как передать знания большой модели компактному трансформеру и использовать одно представление для нескольких задач зрения.
Авторы исследования: Longfei Liu, Yongjie Hou, Yang Li, Qirui Wang, Youyang Sha, Yongjun Yu, Yinzhi Wang, Peizhe Ru, Xuanlong Yu, Xi Shen
Intellindust AI Lab
Перевод страницы проекта и пояснения — Deepvizor. Полный текст научной работы доступен по ссылке PDF. Результаты приведены для исследовательских наборов данных.
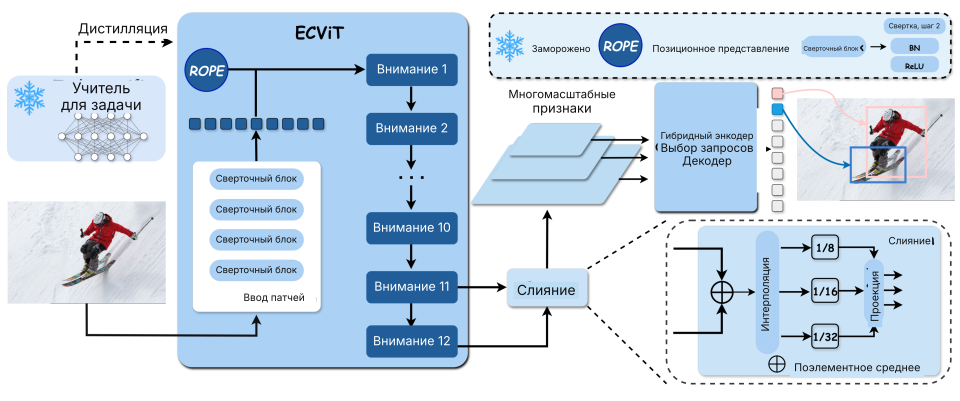
Открыть иллюстрацию в полном размере ↗
Компактной модели нужны признаки, подготовленные под конкретную задачу. EdgeCrafter сначала специализирует учителя на детекции, затем передаёт знания небольшому энкодеру.
Аннотация: что мешает компактным трансформерам
Развёртывание высокопроизводительных моделей плотного предсказания на периферийных устройствах затрудняют ограничения вычислений и памяти. Лёгкие системы детекции, сегментации экземпляров и оценки позы по-прежнему во многом опираются на свёрточные архитектуры, например YOLO. Компактным визуальным трансформерам часто сложнее достичь такого же баланса качества и эффективности даже после масштабного предобучения.
Авторы связывают этот разрыв с недостаточным обучением небольших трансформеров представлениям, специфичным для задачи. В ответ предлагается EdgeCrafter — общая система компактных ViT для плотного предсказания. Её основа — ECDet с дистиллированным небольшим энкодером и архитектурой энкодера-декодера, рассчитанной на локальное выполнение.
Сначала большой ViT, предобученный на DINOv3, адаптируют к детекции. Он становится специализированным учителем и передаёт представления компактным моделям на изображениях ImageNet-1K и COCO. Стандартное разбиение на патчи заменено лёгким свёрточным входным блоком, а многомасштабные признаки формируются интерполяцией и линейной проекцией вместо дорогих пирамид признаков.
Полученное представление переносится на сегментацию экземпляров и оценку позы человека через лёгкие специализированные выходные модули. Так одна линия обучения признаков используется в нескольких задачах.
Три этапа: подготовить, передать, специализировать
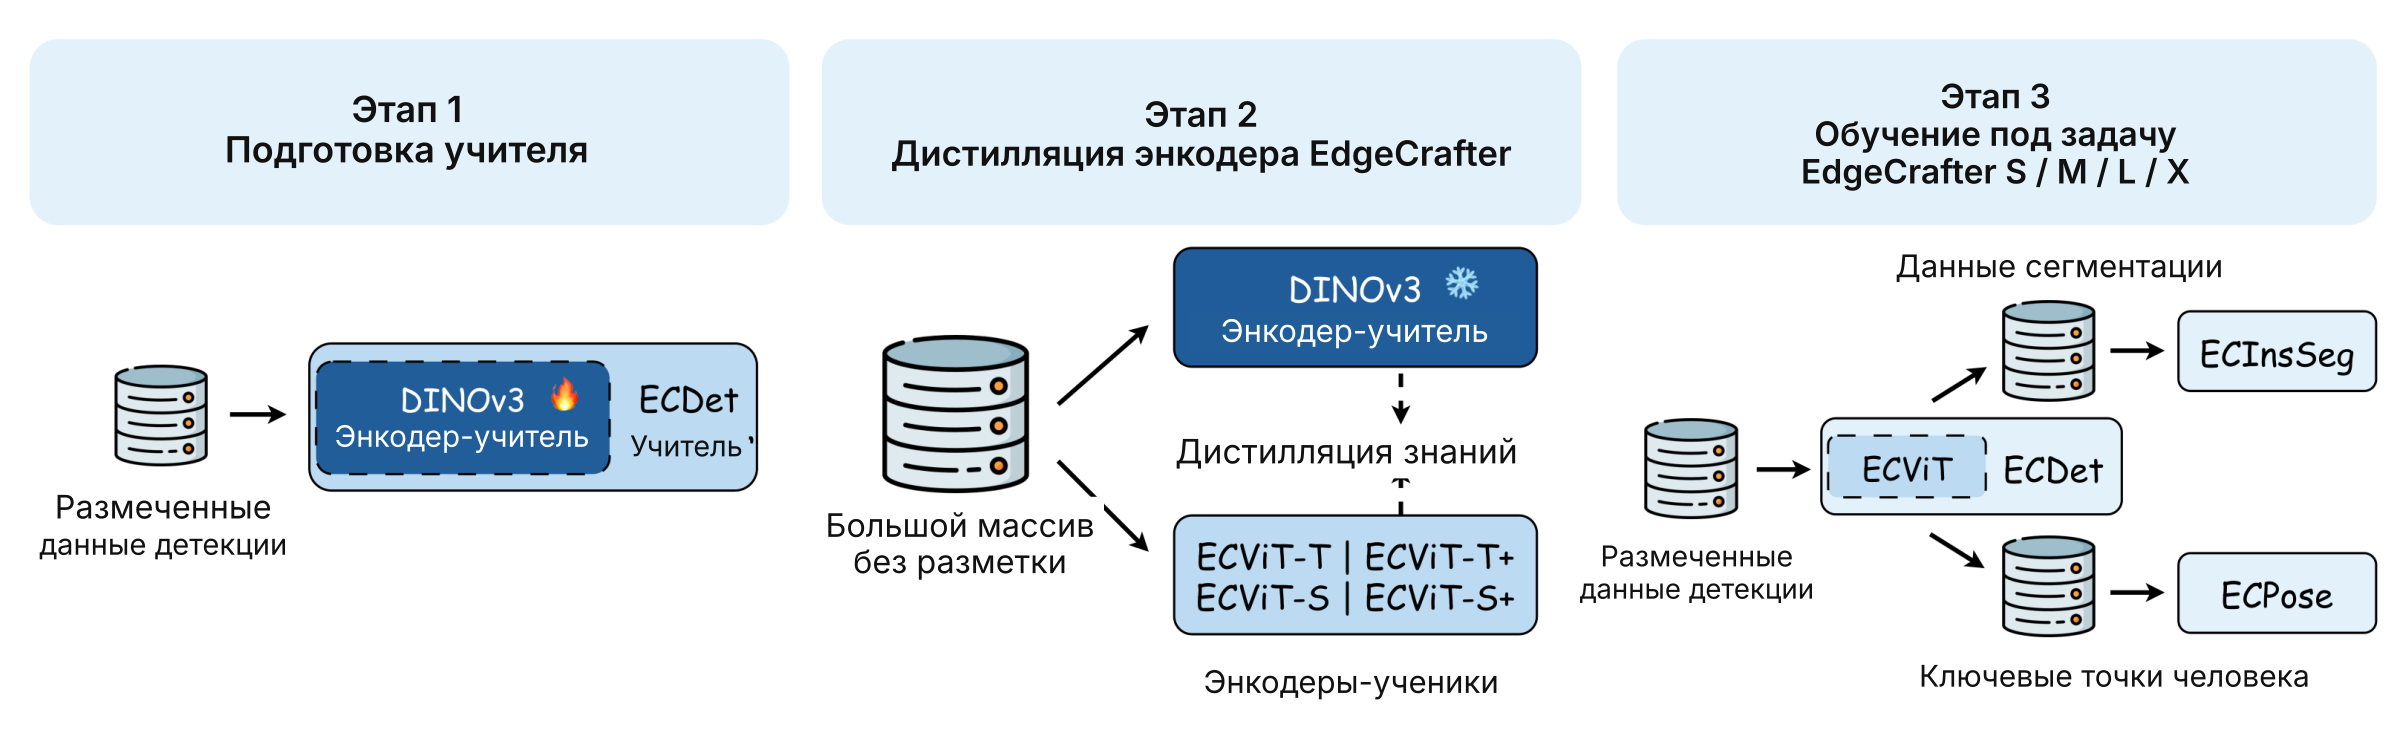
Первый этап — подготовка учителя. Большой энкодер DINOv3 входит в детектор ECDet и обучается на размеченных данных детекции. На схеме обучаемые веса обозначены пламенем.
Второй этап — дистилляция знаний. Учитель заморожен, что отмечено снежинкой, а небольшие энкодеры ECViT-T, T+, S и S+ обучаются на большом массиве изображений без разметки для этой стадии. Учитель передаёт представление сцены, подготовленное именно под детекцию.
Третий этап — обучение под задачу. Для семейств S, M, L и X используются соответствующие данные: рамки объектов для ECDet, маски для ECInsSeg и ключевые точки человека для ECPose. Дистилляция не отменяет предметную разметку на финальном этапе.
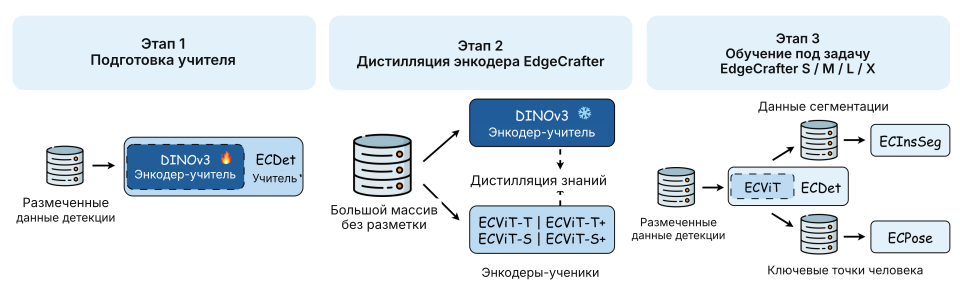
Оригинальный процесс обучения EdgeCrafter: подготовка учителя → дистилляция → обучение под задачу. Схема переведена на русский.
Результаты: детекция, поза и сегментация
При использовании только разметки COCO модель ECDet-S достигает 51,7 box AP при числе параметров менее 10 млн. Для ECInsSeg-X указано 48,4 mask AP, для ECPose-X — 74,8 keypoint AP.
Дополнительное предобучение на Objects365 требует больше вычислений, но улучшает результаты всех размеров. В вариантах X авторы сообщают 59,9 box AP, 49,8 mask AP и 75,9 keypoint AP. В каждой ячейке таблицы первое число относится к обучению только на COCO, второе — к варианту с Objects365.
В таблицах скорости на оригинальном сайте используется NVIDIA T4, размер пакета 1, FP16 и TensorRT 10.6. Это описание конкретного протокола измерения, а не заявленная скорость на любой AI Box. Разные типы AP относятся к разным задачам, поэтому сравнивать box AP и keypoint AP напрямую некорректно.
Прокрутите таблицу по горизонтали →
| Размер | Детекция · box AP | Поза · keypoint AP | Сегментация · mask AP |
|---|---|---|---|
| S | 51.7 / 53.6 | 68.9 / 69.7 | 43.0 / 43.9 |
| M | 54.3 / 56.7 | 72.4 / 73.1 | 45.2 / 46.9 |
| L | 57.0 / 59.0 | 73.5 / 74.5 | 47.1 / 48.8 |
| X | 57.9 / 59.9 | 74.8 / 75.9 | 48.4 / 49.8 |
Комментарий Deepvizor: три представления одной сцены
Детекция отвечает, где находится объект и к какому классу он относится. Сегментация выделяет его область по пикселям. Оценка позы даёт расположение ключевых точек человека. Эти представления полезны для разных правил, но сами по себе ещё не являются готовым событием.
В промышленном сценарии результат модели нужно связать с зоной контроля, длительностью наблюдения и условиями срабатывания. На локальном устройстве важна также совместная нагрузка: декодирование видео, аналитика нескольких камер, запись событий и работа интерфейса. Проверяйте весь сценарий, а не только размер модели.
Первоисточник и библиографическая запись
Работа опубликована в TMLR 2026. Полная научная публикация, репозиторий и расширенные сравнительные таблицы доступны по ссылкам авторов. Ниже сохранена их библиографическая запись.
BibTeX
@article{liu2026edgecrafter,
  title={EdgeCrafter: Compact ViTs for Edge Dense Prediction via Task-Specialized Distillation},
  author={Liu, Longfei and Hou, Yongjie and Li, Yang and Wang, Qirui and Sha, Youyang and Yu, Yongjun and Wang, Yinzhi and Ru, Peizhe and Yu, Xuanlong and Shen, Xi},
  journal={Transactions on Machine Learning Research},
  year={2026}
}
О переводе и источнике
EdgeCrafter: Compact ViTs for Edge Dense Prediction via Task-Specialized Distillation · Longfei Liu, Yongjie Hou, Yang Li, Qirui Wang, Youyang Sha, Yongjun Yu, Yinzhi Wang, Peizhe Ru, Xuanlong Yu, Xi Shen. Перевод страницы проекта, локализация схем и пояснения: Deepvizor, 17.10.2026. Фотографии и экспериментальные данные сохранены. Пояснения Deepvizor выделены отдельно от перевода.
Посмотрите библиотеку детекторов и оборудование Deepvizor.