Обучение детектора по нескольким примерам: метод FT-FSOD
Новый ракурс, промышленная сцена или незнакомый тип оборудования меняют условия распознавания. Работа FT-FSOD показывает, как донастраивать готовый детектор по небольшому набору примеров и проверять его устойчивость.
Авторы исследования: Xuanlong Yu, Youyang Sha, Longfei Liu, Xi Shen, Di Yang
Intellindust AI Lab · Suzhou Institute for Advanced Research, USTC
Научный разбор и перевод подписей — Deepvizor. Исходные иллюстрации и результаты взяты из научной работы; полная публикация доступна по ссылке PDF.
Открыть иллюстрацию в полном размере ↗
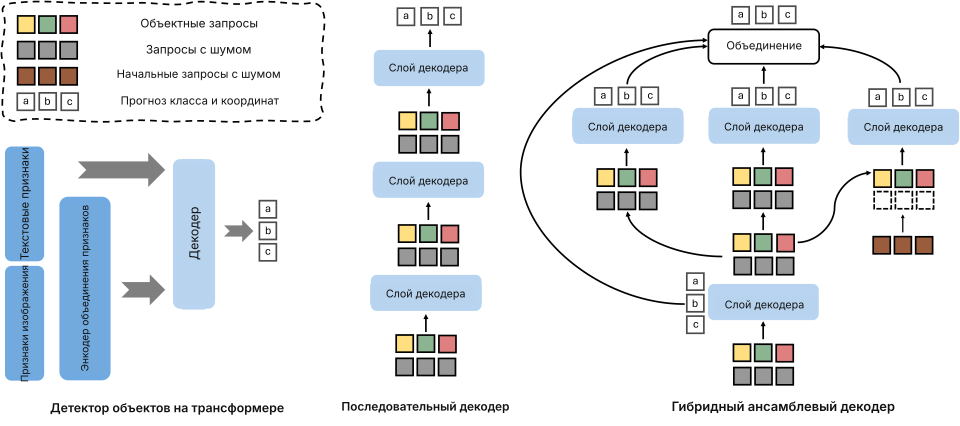
Малый набор данных требует аккуратной адаптации. FT-FSOD сочетает прогрессивную донастройку и гибридный ансамблевый декодер, который разнообразит предсказания без добавления параметров.
Почему распознавание меняется на новом объекте
Обучение детектора объектов обычно опирается на размеченные изображения: на них указаны классы и координаты рамок. На предприятии условия могут заметно отличаться от исходных данных. Промышленная деталь, камера под потолком и слабое освещение дают другую картину, чем привычные фотографии из открытых наборов.
Такое изменение называют сдвигом домена. Детектор может узнавать нужный класс в одном окружении и ошибаться в другом. В задаче cross-domain few-shot object detection одновременно мало примеров и велико отличие новой сцены. Поэтому вопрос состоит не только в количестве разметки, но и в способе адаптации модели.
FT-FSOD исследует донастройку предобученных детекторов в этих условиях. Научная работа принята на CVPR 2026. Ниже — её методы и результаты, а затем практические выводы для проверки видеоаналитики на предприятии.
Как работает гибридный ансамблевый декодер
В детекторах семейства DETR признаки изображения взаимодействуют с обучаемыми объектными запросами. Слои декодера уточняют класс и положение объекта. В обычной последовательной схеме каждый следующий слой получает выход предыдущего.
Hybrid Ensemble Decoder, или HED, сохраняет общие начальные слои и переводит часть последующих слоёв в параллельные ветви. Их предсказания объединяются. Разные ветви дают более разнообразные оценки одной сцены, что помогает обобщению при переходе к новому домену.
Для обучения используются также запросы с шумом — denoising queries, обозначенные DN. Часть запросов наследуется, часть переинициализируется. Это добавляет разнообразие входов параллельных ветвей. Метод переиспользует предобученные веса без добавления параметров, а не строит несколько независимых больших моделей.
На переведённой схеме в начале статьи цветные квадраты обозначают объектные запросы, серые — запросы с шумом, коричневые — начальные шумовые запросы. Буквы a, b и c обозначают предсказания класса и координат, а не реальные названия классов.
Прогрессивная донастройка по небольшому набору данных
На первом этапе энкодер заморожен: обучение меняет оставшиеся части детектора, сохраняя исходное представление изображения. Когда улучшение выходит на плато, энкодер размораживается. Так модель получает возможность адаптировать признаки после более осторожного начального этапа.
Скорость обучения управляется с учётом плато. Авторы используют общий подход для разных наборов вместо отдельного большого поиска гиперпараметров для каждой задачи. Сложная генерация дополнительных данных не является обязательной частью предложенного рецепта.
Важно различать few-shot и работу без обучения. FT-FSOD меняет веса модели на размеченных примерах. Ранее разобранный FSOD-VFM, напротив, использует базовые модели и графовую диффузию без дополнительного обучения детектора. Это два разных способа адаптации, и сравнивать их следует с учётом подготовки данных и ресурсов.
Что показали научные эксперименты
Авторы проверяют метод на CD-FSOD, ODinW-13 и RF100-VL. Набор RF100-VL объединяет 100 разнородных задач. В режиме 10-shot итоговый средний mAP предложенного подхода составляет 41,9; в том же сравнении для SAM3 приведено 35,7. Разница равна 6,2 пункта mAP.
10-shot означает десять размеченных примеров на класс в протоколе исследования. Это не обещание, что десяти кадров достаточно для любой заводской камеры. Также в оригинальной таблице отмечены различия процедур выбора моделей: полные условия сравнения приведены в работе.
mAP усредняет точность обнаружения по правилам конкретного теста. Эту метрику нельзя напрямую читать как долю правильно доставленных тревог или заменять ею оценку рабочего сценария предприятия.
Прокрутите таблицу по горизонтали →
| Метод | Средний mAP |
|---|---|
| SAM3 | 35.7 |
| FT-FSOD · MMGDINO-L | 41.9 |
Незнакомые данные и слишком уверенные ошибки
Для проверки устойчивости авторы строят CD-Mixed: изображения целевого домена смешиваются с данными из других доменов. Модель, адаптированная к одному набору, встречает посторонние сцены. Это проверяет, не выдаёт ли она уверенные рамки там, где целевого объекта нет.
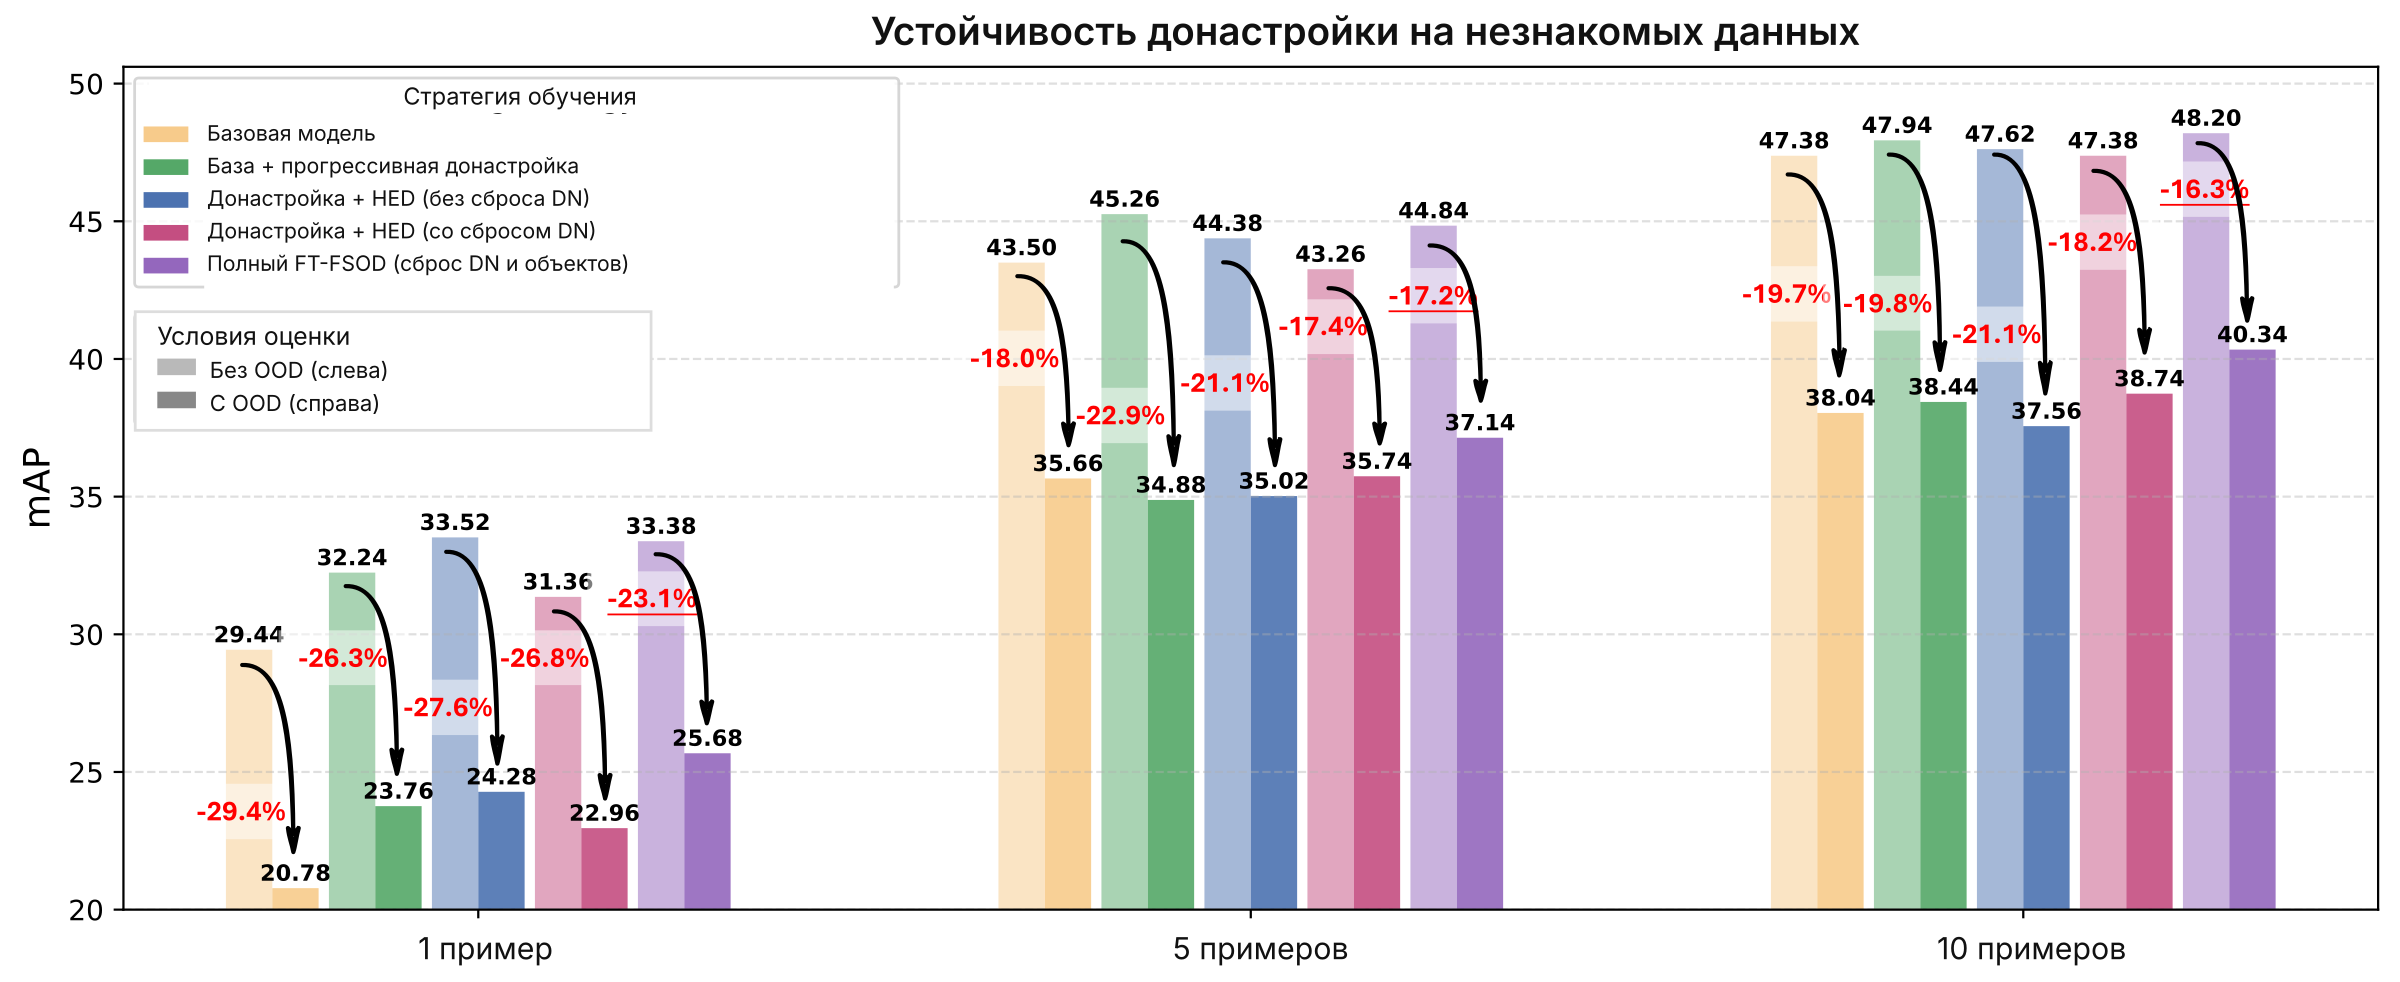
На исходном графике для 10 примеров базовая модель имеет 47,38 mAP без OOD и 38,04 с OOD. Полный FT-FSOD — 48,20 и 40,34 соответственно. График сохраняет все пять стратегий обучения, численные значения и процент снижения из оригинала. Прогрессивная донастройка сама по себе не улучшает каждый показатель одинаково: важна совместная оценка компонентов.
В пилоте этот принцип означает проверку обычной рабочей сцены без нарушения, соседнего оборудования и похожих объектов. Видеоклипы без целевого события помогают увидеть лишние срабатывания, которые не заметны на подборке успешных обнаружений.
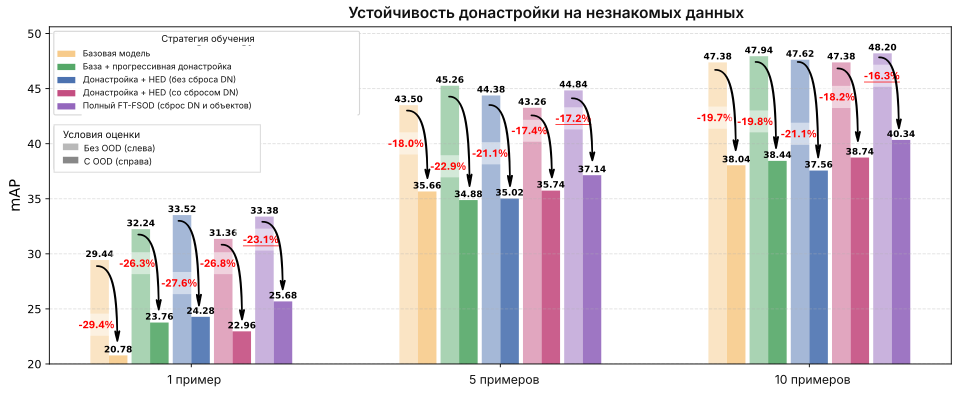
Исходный график из работы FT-FSOD. OOD — данные вне целевого распределения; DN — запросы с шумом. Подписи переведены, числа и относительные изменения сохранены.
Как готовить данные для адаптации видеоаналитики
Начните с определения класса и правила события. Например, «погрузчик в зоне» включает обнаружение техники, её положение и проверку границ. Даже хорошая адаптация детектора решает только часть этой цепочки.
Соберите разные независимые эпизоды: несколько ракурсов, рабочие расстояния, перекрытия и освещение. В разметке придерживайтесь одного правила рамки и названия класса. Для проверки оставьте другой день или отдельную камеру, чтобы соседние кадры одной записи не оказались одновременно в подготовке и испытании.
Оценивайте пропуски и ложные обнаружения вместе. После этого подключите правило события, личный кабинет и нужный канал реакции. Данные научного теста служат основанием для выбора подхода; результат внедрения подтверждают на камерах вашего объекта.
Вопросы об обучении детектора
Сколько примеров нужно? В статье исследуются режимы 1, 5 и 10 примеров и дополнительные бенчмарки. Для предприятия объём данных зависит от разнообразия объекта и условий съёмки; число из бенчмарка не задаёт готовый норматив.
Нужно ли размечать видео целиком? Для донастройки детектора нужны размеченные изображения с целевыми объектами. Для проверки временного сценария дополнительно нужны полные эпизоды. Подготовку обучения и проверку событий удобно вести отдельно.
Что выбрать: донастройку или готовый детектор? Сначала проверьте существующий детектор на своих камерах. Если проблема связана с плохим ракурсом, адаптация модели не вернёт отсутствующие детали. Если условия и класс действительно новые, обсуждают подготовку данных и донастройку.
BibTeX
@inproceedings{yu2026acloser,
  title={A Closer Look at Cross-Domain Few-Shot Object Detection: Fine-Tuning Matters and Parallel Decoder Helps},
  author={Yu, Xuanlong and Sha, Youyang and Liu, Longfei and Shen, Xi and Yang, Di},
  booktitle={CVPR},
  year={2026}
}
Источники и права
FT-FSOD · Xuanlong Yu, Youyang Sha, Longfei Liu, Xi Shen, Di Yang. Иллюстрации и исследование: CC BY 4.0. Перевод подписей и научный разбор: Deepvizor, 15.10.2026. Геометрия схем, фотографии и численные значения сохранены; примеры GTR снабжены подписями столбцов.
Посмотрите библиотеку детекторов и оборудование Deepvizor.