Сегментация изображений в видеоаналитике: метод GTR
Рамка показывает, где находится объект. Сегментация уточняет, какие пиксели ему принадлежат. Исследование GTR объединяет эффективное извлечение признаков с несколькими задачами компьютерного зрения — от масок до оценки позы.
Авторы исследования: Zhe Feng, Longfei Liu, Wei Liu, Kai Chen, Jiangang Kong, Wei Zhou, Yifeng Qian, Dexiong Chen, Xuanlong Yu, Xi Shen
Didi · Intellindust AI Lab · Institute of Automation, Chinese Academy of Sciences · HKUST (Guangzhou)
Научный разбор и перевод подписей — Deepvizor. Исходные иллюстрации и результаты взяты из научной работы; полная публикация доступна по ссылке PDF.
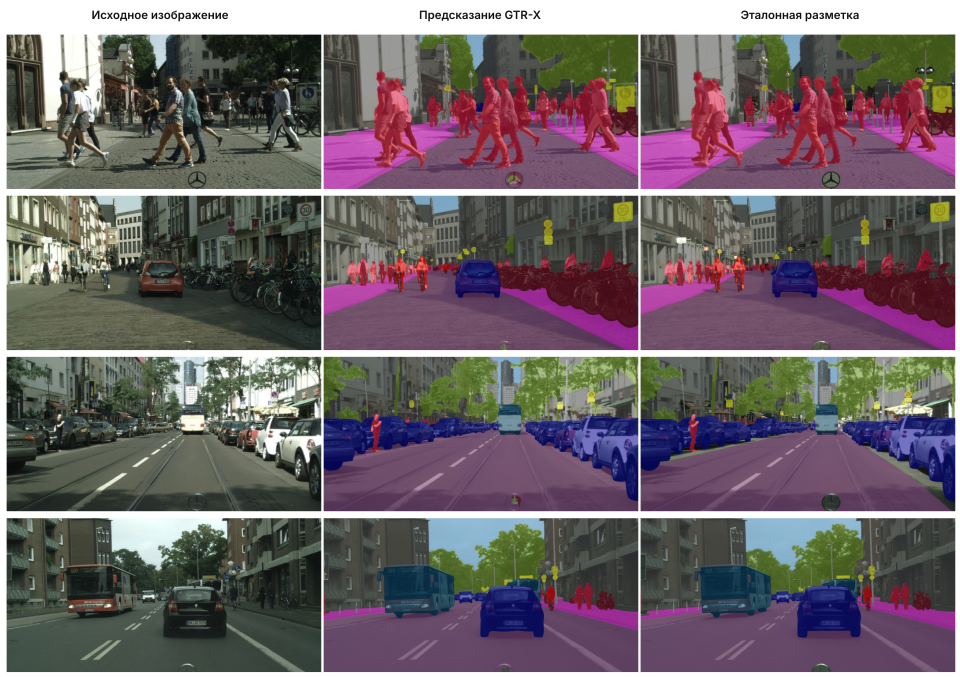
Открыть иллюстрацию в полном размере ↗
Сегментация описывает форму и области сцены, а не только рамки. GTR исследует общий дизайн извлечения признаков с линейным вниманием для отдельных моделей под разные задачи.
Что такое сегментация изображения
Обнаружение объектов возвращает класс и прямоугольную рамку. Сегментация работает подробнее: она присваивает пикселям метки или объединяет их в маску объекта. На исходных примерах GTR видны области людей, транспорта, дороги и окружающей сцены.
При семантической сегментации каждый пиксель получает класс: например, «человек» или «дорога». При сегментации экземпляров система дополнительно разделяет разные объекты одного класса. Два человека могут иметь одну семантическую метку, но две отдельные маски.
Выбор зависит от задачи. Для подсчёта или пересечения линии часто достаточно рамки и сопровождения объекта. Если нужно точнее описать занятую область или форму, маска даёт более подробное представление. Прикладное правило всё равно задаётся отдельно.
Почему подробное изображение увеличивает нагрузку
В трансформерных моделях изображение делится на фрагменты — токены. Глобальное softmax-внимание сопоставляет токены между собой. При росте разрешения число токенов увеличивается, а стоимость такого взаимодействия растёт квадратично.
Gated Token Recurrence, или GTR, заменяет глобальное softmax-внимание рекуррентным обменом информации с управляемыми шлюзами и линейным вниманием GLA. При фиксированной ширине модели зависимость от числа токенов становится линейной. Это создаёт другой баланс детализации, памяти и вычислений.
В работе изучается архитектура извлечения признаков, а не готовая система управления тревогами. Работа опубликована как препринт arXiv в сентябре 2026 года; протоколы и ограничения экспериментов доступны по ссылке на полный текст.
Как GTR собирает контекст сцены
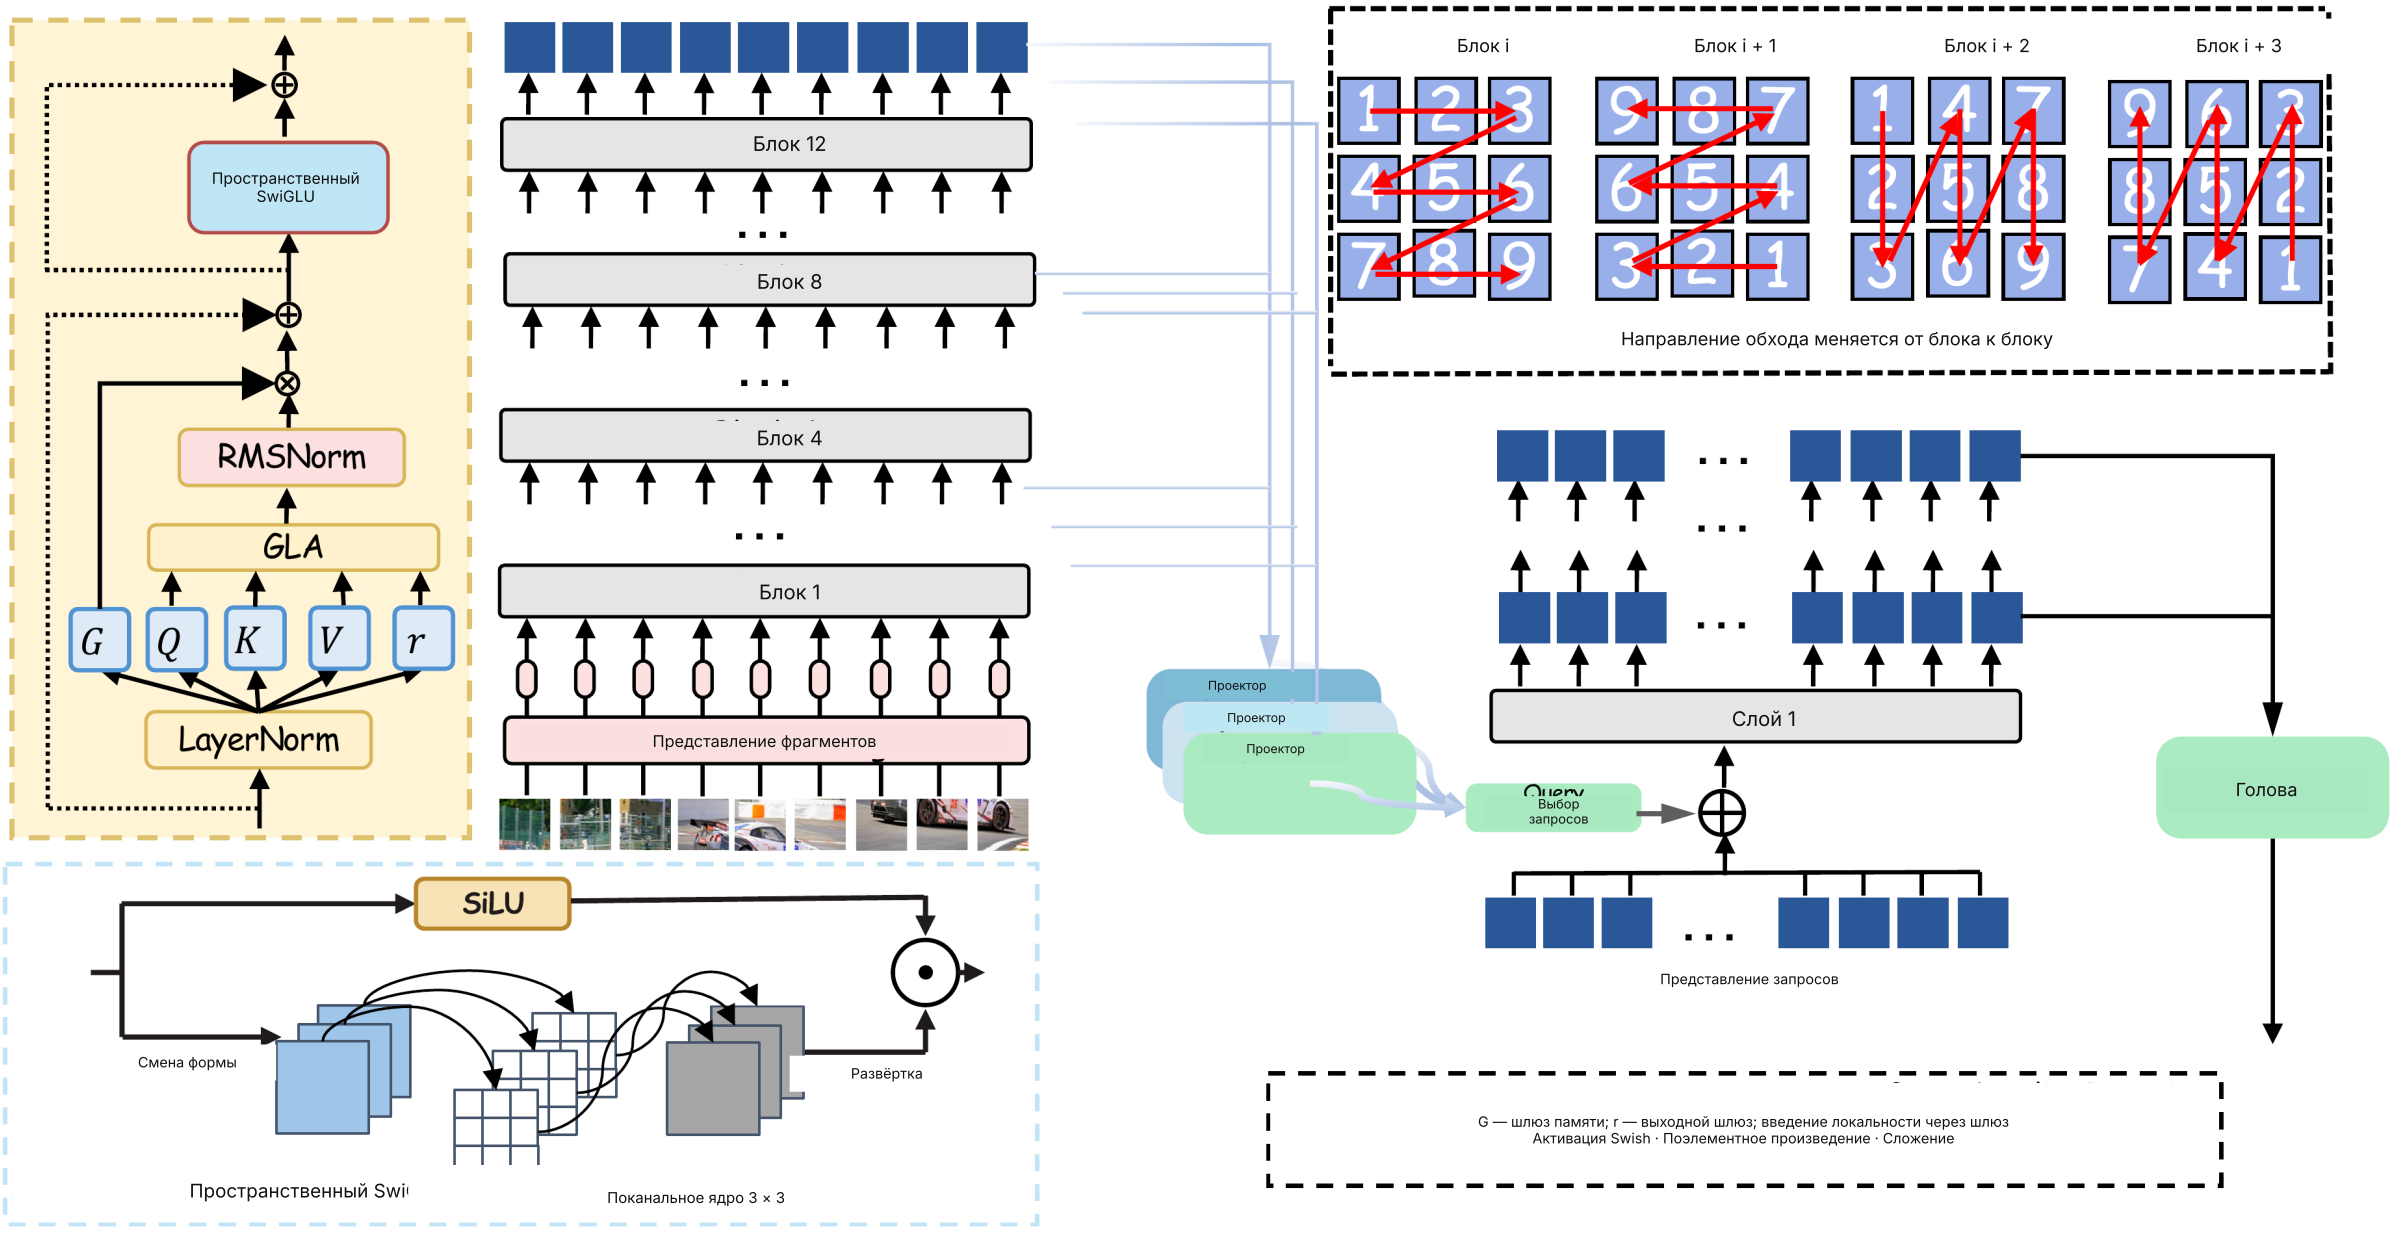
Модель сохраняет одну сетку фрагментов с шагом 16 через 12 блоков. Каждый блок делает один направленный обход. Последовательные блоки меняют направления: слева направо, справа налево, сверху вниз и снизу вверх. Так признаки получают пространственный контекст с разных сторон.
Это обход частей одного изображения, а не память между видеокадрами. Для анализа действия во времени необходим дополнительный временной подход. Рекуррентность в названии GTR сама по себе не означает распознавание падения или последовательности действий.
Модуль Spatial SwiGLU дополняет обмен токенами локальным пространственным смешиванием. Признаки из блоков 4, 8 и 12 поступают в лёгкую пирамиду масштабов. Для обнаружения далее используется декодер типа DETR с 300 запросами.
На переведённой схеме сохранены стрелки обхода, номера блоков и математические обозначения. GLA, RMSNorm, LayerNorm, SiLU и SwiGLU оставлены как названия методов, чтобы их можно было найти в исходном коде.
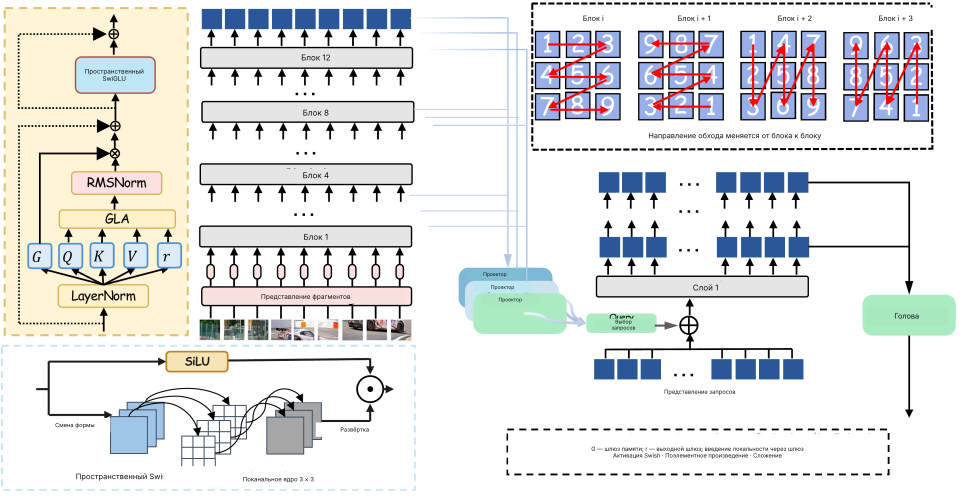
Исходная схема архитектуры GTR с русскими подписями. Геометрия, стрелки, номера и условные обозначения сохранены.
Дистилляция: как передаются признаки сильной модели
В качестве учителя используется DINOv3, специализированный для обнаружения по рецепту EdgeCrafter. Его параметры заморожены. Учитель и GTR получают одно полное изображение, поэтому позиции фрагментов совпадают.
Обучаемая линейная проекция согласует размерности признаков. Единственная цель дистилляции — квадратичная ошибка между финальными признаками фрагментов ученика и учителя. В этом этапе нет маскирования входа и отдельных потерь для промежуточных слоёв.
Дистилляция даёт начальное представление, после чего модели обучаются под конкретные задачи. Общий дизайн применяется к обнаружению, сегментации экземпляров, оценке позы, ориентированным рамкам, семантической сегментации и глубине. Это отдельные модели под задачи, а не утверждение об одной модели, выполняющей всё одновременно.
Точность, разрешение и скорость: что измерено
Для обнаружения GTR-L с предварительным обучением детектора на Objects365 получает 58,9 box AP на COCO val2017. Медиана одного прямого прохода — 1,908 мс на RTX 4090: FP16, batch 1, torch.compile и CUDA Graphs. Это время модели по заданному протоколу, не задержка всей системы от камеры до уведомления.
При увеличении входа GTR-S с 640 × 640 до 1280 × 1280 точность обнаружения растёт с 53,6 до 57,0 AP. Для мелких объектов APS увеличивается с 36,4 до 42,4. Медиана прохода меняется с 1,225 до 2,529 мс, пиковая память — с 0,096 до 0,249 ГБ. Эти показатели относятся к ветви обнаружения, не являются метриками сегментации.
Отдельное развёртывание TensorRT на DRIVE AGX Thor проверено для шести задач и четырёх размеров модели. Таблица ниже содержит исходные медианы batch 1 в миллисекундах. Для ориентированных рамок и семантической сегментации использован вход 1024 × 1024, для остальных задач — 640 × 640.
Прокрутите таблицу по горизонтали →
| Задача | Вход | GTR-S | GTR-M | GTR-L | GTR-X |
|---|---|---|---|---|---|
| Обнаружение | 640² | 2.282 | 2.721 | 3.527 | 4.080 |
| Сегментация экземпляров | 640² | 3.474 | 4.363 | 5.130 | 5.703 |
| Оценка позы | 640² | 2.459 | 3.082 | 3.909 | 4.455 |
| Ориентированные рамки | 1024² | 4.310 | 5.491 | 7.602 | 8.769 |
| Семантическая сегментация | 1024² | 3.579 | 4.655 | 6.792 | 7.916 |
| Монокулярная глубина | 640² | 2.675 | 3.071 | 3.872 | 4.389 |
Как проверять сегментацию на камерах предприятия
Сначала решите, что должно возвращать распознавание: рамку, отдельную маску объекта или карту классов всей сцены. Например, для контроля занятой области важно заранее определить, какие пиксели считать объектом и как измерять пересечение с зоной.
Проверяйте границы на сложных случаях: человек рядом с техникой, частичное перекрытие, отражение, маленький объект вдали. Подготовьте эталонную разметку и оценивайте не только красивый цветной слой, но и ошибки на границах и пропущенные объекты.
Нагрузку измеряют при всех нужных потоках: получение видео, декодирование, обработка и передача события. Показатель на RTX 4090 или Thor не переводится автоматически в число камер микросервера. После проверки распознавания добавляют правила, уведомления и реакцию периферии.
Вопросы о сегментации и видеоаналитике
Всегда ли маска лучше рамки? Нет. Маска даёт форму объекта, но добавляет требования к разметке и оценке. Для части сценариев достаточно рамки и сопровождения. Выбор определяется бизнес-правилом и условиями камеры.
Сегментация сама распознаёт действие? Она описывает область и форму в изображении. Действие требует изменений во времени, поэтому для анализа эпизода нужен видеоряд и подходящий временной метод.
Можно ли обрабатывать видео локально? Архитектуру можно построить с вычислителем в сети объекта. Конкретную модель, ускоритель и число потоков подбирают по совместимости и испытаниям; опубликованный бенчмарк GTR описывает собственные аппаратные конфигурации.
BibTeX
@article{gtr2026feng,
  title={GTR: Gated Token Recurrence for Efficient Dense Prediction},
  author={Feng, Zhe and Liu, Longfei and Liu, Wei and Chen, Kai and Kong, Jiangang and Zhou, Wei and Qian, Yifeng and Chen, Dexiong and Yu, Xuanlong and Shen, Xi},
  journal={arXiv preprint arXiv:2609.26590},
  year={2026}
}
Источники и права
GTR · Zhe Feng, Longfei Liu, Wei Liu, Kai Chen, Jiangang Kong, Wei Zhou, Yifeng Qian, Dexiong Chen, Xuanlong Yu, Xi Shen. Иллюстрации и исследование: CC BY 4.0. Перевод подписей и научный разбор: Deepvizor, 15.10.2026. Геометрия схем, фотографии и численные значения сохранены; примеры GTR снабжены подписями столбцов.
Посмотрите библиотеку детекторов и оборудование Deepvizor.