Детекция объектов в реальном времени: DEIMv2 и DINOv3
Быстрый детектор должен одновременно замечать детали сцены и укладываться в вычислительный бюджет. В DEIMv2 знания DINOv3 соединены с архитектурой для устройств разной мощности — от GPU до компактных вычислителей.
Авторы исследования: Shihua Huang, Yongjie Hou, Longfei Liu, Xuanlong Yu, Xi Shen
Intellindust AI Lab · Xiamen University
Перевод страницы проекта и пояснения — Deepvizor. Полный текст научной работы доступен по ссылке PDF. Результаты приведены для исследовательских наборов данных.
Открыть иллюстрацию в полном размере ↗
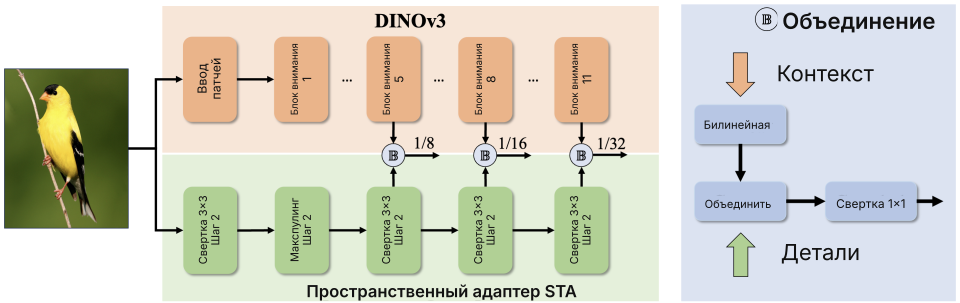
DEIMv2 — семейство из восьми размеров, а не одна универсальная модель. Адаптер STA объединяет контекст и локальные детали; компактные варианты используют другой базовый энкодер.
Аннотация: восемь моделей для разных устройств
Простой и эффективный механизм Dense O2O позволил DEIM быстрее сходиться при обучении и улучшить результаты. В этой работе авторы расширяют подход признаками DINOv3 и получают DEIMv2. Семейство включает восемь размеров — от X до Atto — для GPU, периферийных и мобильных устройств.
В вариантах X, L, M и S используются энкодеры, предобученные на DINOv3 или полученные дистилляцией. Пространственный адаптер Spatial Tuning Adapter, или STA, преобразует одномасштабный выход DINOv3 в многомасштабные признаки. Он дополняет сильное семантическое представление мелкими деталями, необходимыми для обнаружения объектов.
Для сверхлёгких Nano, Pico, Femto и Atto авторы используют HGNetv2 с сокращением глубины и ширины. Это позволяет соблюдать жёсткие ограничения по ресурсам. Упрощённый декодер и обновлённый Dense O2O объединяют варианты в одну систему с разным соотношением качества и стоимости вычислений.
Метод: контекст и детали на нескольких масштабах
На исходной схеме верхняя ветвь извлекает признаки DINOv3. Нижняя ветвь STA получает локальные детали через свёрточные операции и уменьшение пространственного разрешения. Узлы объединения связывают два представления.
В результате формируются признаки с масштабами 1/8, 1/16 и 1/32 от исходного изображения. Схема справа раскрывает узел Bi-Fusion: билинейное изменение масштаба, объединение каналов и свёртку 1 × 1. Это пояснение к опубликованной архитектуре, а не отдельный эксперимент Deepvizor.
Семантические признаки помогают определить, что находится в кадре. Более локальное представление даёт информацию о границах и небольших элементах. STA сохраняет оба типа информации перед последующими этапами детекции.
Результаты: качество и число параметров
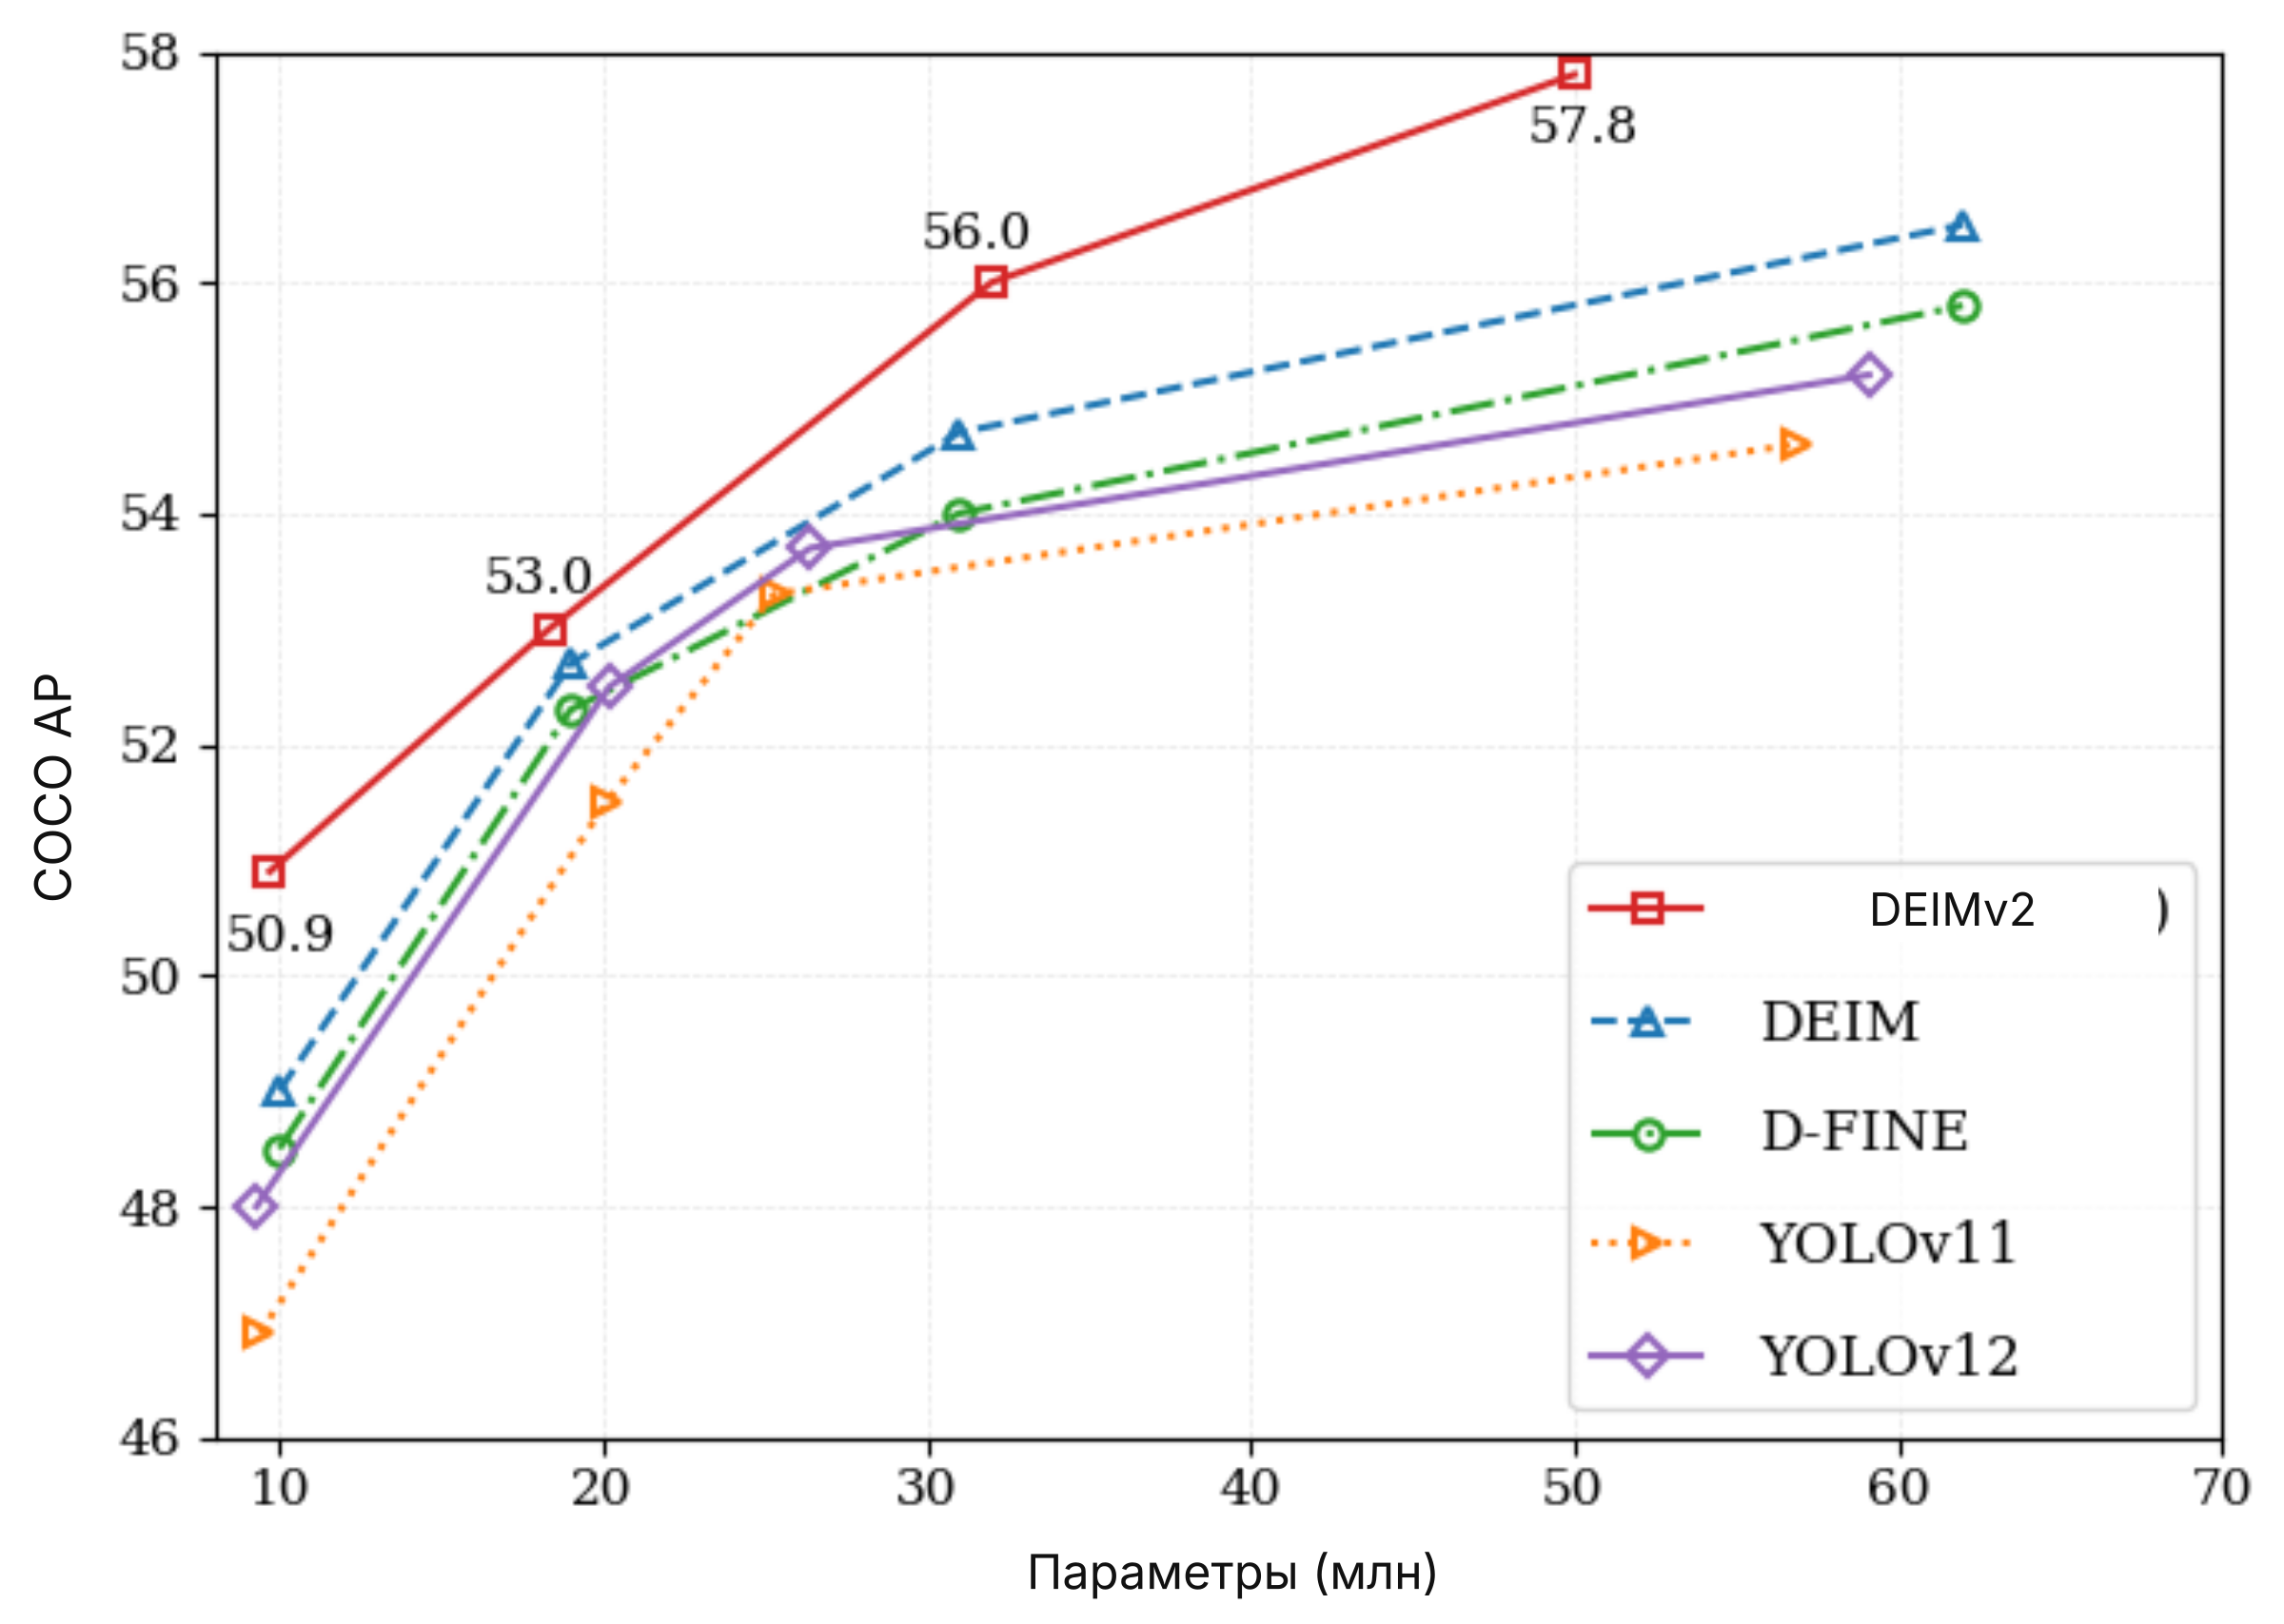
DEIMv2-X достигает 57,8 AP при 50,3 млн параметров. Для DEIMv2-S авторы сообщают 50,9 AP при 9,71 млн параметров: это заявленный в работе переход рубежа 50 AP для модели меньше 10 млн параметров.
У DEIMv2-Pico — 1,5 млн параметров и 38,5 AP. На странице сравнивается тот же AP у YOLOv10-Nano с 2,3 млн параметров. Ниже сохранены исходные значения для трёх вариантов, прямо названных в аннотации.
AP — метрика детекции на исследовательском наборе COCO. Её нельзя читать как процент верно обработанных тревог на предприятии. График показывает соотношение AP и числа параметров, а не измеренную задержку на устройствах Deepvizor.
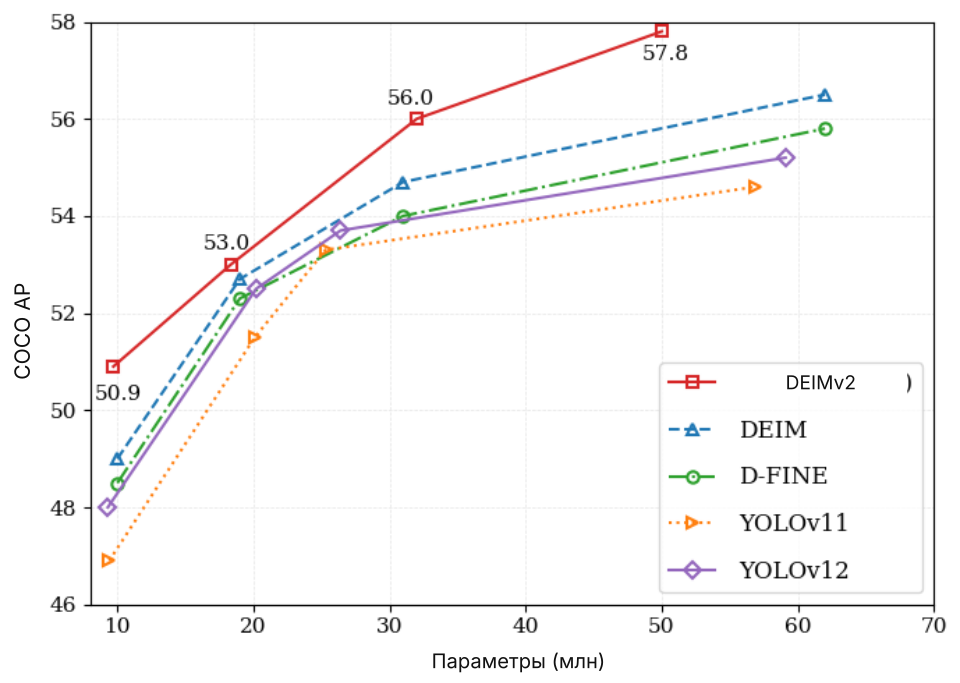
Исходный график AP и числа параметров. Подписи осей переведены; кривые и значения сохранены.
Открыть переведённую иллюстрацию ↗
Прокрутите таблицу по горизонтали →
| Модель | Параметры, млн | AP |
|---|---|---|
| DEIMv2-X | 50.3 | 57.8 |
| DEIMv2-S | 9.71 | 50.9 |
| DEIMv2-Pico | 1.5 | 38.5 |
Комментарий Deepvizor: как выбирать размер модели
Начинайте с требуемого события и условий камеры. Небольшой объект в дальнем углу кадра и крупный объект у прохода могут требовать разного разрешения входа и разного запаса качества. Одинаковое название алгоритма не гарантирует одинаковую нагрузку.
При пилоте измеряйте задержку всей цепочки: получение видеопотока, декодирование, обработку, проверку правила и уведомление. Сравнивайте модели на одинаковом видео и целевом оборудовании. Объём памяти, формат вычислений и число параллельных камер важны наряду с количеством параметров.
Оригинальная публикация и код
Код и предобученные веса опубликованы в репозитории DEIMv2. Ссылки на оригинальную страницу и полную научную работу находятся в начале статьи. Ниже — библиографическая запись авторов.
BibTeX
@article{huang2025deimv2,
  title={Real-Time Object Detection Meets DINOv3},
  author={Huang, Shihua and Hou, Yongjie and Liu, Longfei and Yu, Xuanlong and Shen, Xi},
  journal={arXiv},
  year={2025}
}
О переводе и источнике
Real-Time Object Detection Meets DINOv3 · Shihua Huang, Yongjie Hou, Longfei Liu, Xuanlong Yu, Xi Shen. Перевод страницы проекта, локализация схем и пояснения: Deepvizor, 17.10.2026. Фотографии и экспериментальные данные сохранены. Пояснения Deepvizor выделены отдельно от перевода.
Посмотрите библиотеку детекторов и оборудование Deepvizor.